Architecture
JEPA model components, encoder options, and configuration
JEPA Overview
tickle uses a Joint-Embedding Predictive Architecture (JEPA) for stock price prediction. Unlike generative models that predict exact prices, JEPA learns representations in a joint embedding space, making it more robust to market noise.
Context (30 ticks) → [Encoder] → Embedding z_c
                                      ↓
                                 [Predictor] →→→→ Predicted ẑ_t
                                      ↓
                                 [Decoder] → Price Distribution (mean, std)

Target (tick 31) → [Encoder] → Embedding z_t (stop-gradient)

Loss: L2(ẑ_t, z_t) + NLL(price | predicted_distribution)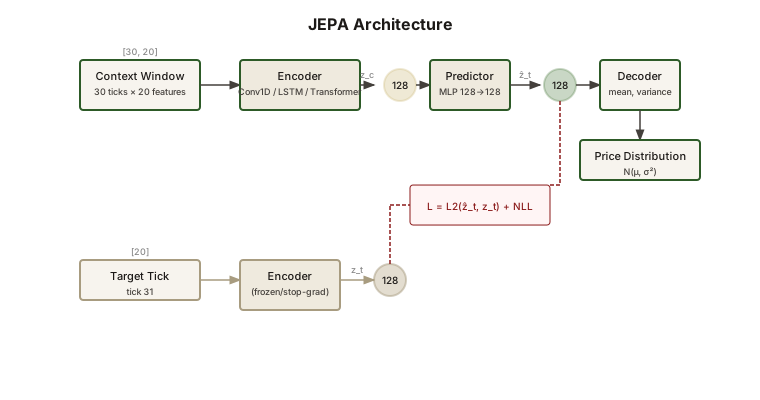
Model Components
Encoder
The encoder compresses a sequence of tick data into a fixed-dimensional embedding. Three encoder architectures are available:
| encoder | description | parameters | speed | best for |
|---|---|---|---|---|
| Conv1D | Local pattern detection with dilated convolutions | ~300K | ~65 it/s | Quick iteration |
| LSTM | Sequential modeling with hidden state | ~500K | ~55 it/s | Lowest MSE |
| Transformer | Attention-based, captures long-range dependencies | ~1.2M | ~45 it/s | Best NLL |
Predictor
The predictor maps context embeddings to target embedding predictions:
- MLP: Simple feedforward mapping (128→256→128)
- GRU: Recurrent predictor for temporal dynamics (performs ~9% worse)
Recommendation: Use MLP predictor. GRU adds parameters without benefit for 1-step prediction.
Decoder
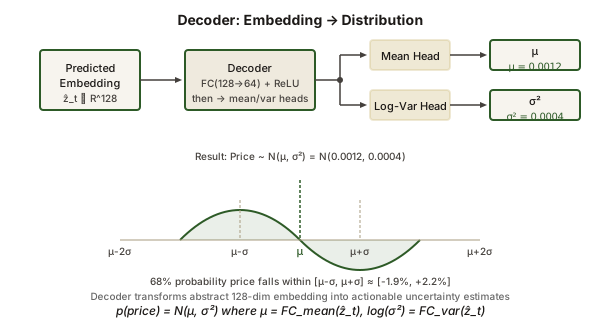
The decoder transforms the 128-dimensional predicted embedding (ẑ_t) into a price distribution. Unlike deterministic models that predict a single price, the decoder outputs both a mean (μ) and variance (σ²), giving us a full probability distribution.
How It Works (Concrete Example)
Suppose the predictor outputs an embedding ẑ_t for the next tick. The decoder performs:
# Step 1: Process embedding through hidden layer
h = ReLU(FC(ẑ_t))              # 128 → 64 dimensions

# Step 2: Split into mean and log-variance
μ = mean_head(h)               # Predicted log-return: e.g., +0.12%
log_var = var_head(h)          # Log-variance: e.g., -7.82
σ² = exp(log_var)              # Variance: 0.0004 (std dev ≈ 2%)

# Result: Price ~ N(0.0012, 0.0004)
# Interpretation: 68% chance next tick is within ±2% of current price
Why this matters: The variance tells us the model's uncertainty. High variance = low confidence (maybe during volatile periods). Low variance = high confidence. This enables Kelly-inspired position sizing where we bet more when confident and less (or not at all) when uncertain.
Code Implementation
class LogReturnDecoder(nn.Module):
    """Predicts log-return distributions (mean and variance)"""

    def __init__(self, embedding_dim=128, hidden_dim=64):
        super().__init__()
        self.fc1 = nn.Linear(embedding_dim, hidden_dim)
        self.mean_head = nn.Linear(hidden_dim, 1)
        self.log_var_head = nn.Linear(hidden_dim, 1)

    def forward(self, predicted_embedding):
        h = F.relu(self.fc1(predicted_embedding))
        mean = self.mean_head(h)
        log_var = self.log_var_head(h)
        return mean, torch.exp(log_var)  # (μ, σ²)
Configuration Examples
Choosing an Architecture
Select based on your priority:
- Best NLL (uncertainty calibration): Transformer + MLP (-1.26 NLL)
- Best MSE (point predictions): LSTM + MLP (0.0004 MSE)
- Fastest training: Conv1D + MLP (~65 it/s)
Conv1D + MLP (Fastest)
# configs/conv1d_mlp.yaml
model:
  encoder_type: conv1d
  encoder:
    input_dim: 20
    hidden_dims: [64, 128]
    embedding_dim: 128
    kernel_size: 3
    dropout: 0.1
  predictor_type: mlp
  predictor:
    embedding_dim: 128
    hidden_dims: [128, 128]
  decoder:
    embedding_dim: 128
    hidden_dim: 64
    output_features: 5
  use_jepa: true
  use_stop_gradient: true
  ema_decay: null

training:
  n_epochs: 50
  batch_size: 256
  learning_rate: 0.001
  context_window: 30
  prediction_horizon: 1
LSTM + MLP (Best MSE)
# configs/lstm_mlp.yaml
model:
  encoder_type: lstm
  encoder:
    input_dim: 20
    hidden_dim: 128
    num_layers: 2
    embedding_dim: 128
    dropout: 0.1
  predictor_type: mlp
  predictor:
    embedding_dim: 128
    hidden_dims: [128, 128]
Transformer + MLP (Best NLL)
# configs/transformer_attn.yaml
model:
  encoder_type: transformer
  encoder:
    input_dim: 20
    d_model: 128
    nhead: 4
    num_layers: 4
    dim_feedforward: 256
    dropout: 0.1
    embedding_dim: 128
  predictor_type: mlp
  predictor:
    embedding_dim: 128
    hidden_dims: [128, 128]
Baseline (No JEPA)
# configs/conv1d_mlp_baseline.yaml
model:
  encoder_type: conv1d
  encoder:
    input_dim: 20
    hidden_dims: [64, 128]
    embedding_dim: 128
  predictor_type: mlp
  decoder:
    embedding_dim: 128
    hidden_dim: 64
    output_features: 5
  use_jepa: false  # Direct prediction, no embedding loss
Input Features
The model processes 20 input features per tick:
| category | features | description |
|---|---|---|
| Price | 5 | Open, High, Low, Close, VWAP (log-normalized) |
| Technical | 15 | RSI, MACD, Bollinger Bands, ATR, ADX, ROC, Volume EMA, etc. |
Technical Indicators
# src/features.py - 15 technical indicators
indicators = [
    'rsi_14',           # Relative Strength Index
    'macd',             # MACD line
    'macd_signal',      # MACD signal line
    'macd_hist',        # MACD histogram
    'bb_upper',         # Bollinger Bands upper
    'bb_lower',         # Bollinger Bands lower
    'bb_width',         # Bollinger Bands width
    'atr_14',           # Average True Range
    'adx_14',           # Average Directional Index
    'roc_10',           # Rate of Change
    'volume_ema_20',    # Volume EMA
    'volume_ratio',     # Current vs average volume
    'price_range',      # High - Low
    'body_size',        # |Close - Open|
    'upper_shadow',     # High - max(Open, Close)
]
All features are normalized per stock using z-score normalization within the context window.
Online Learning Components (Phase 13)
Dynamic parameter adaptation system for optimizing exit thresholds based on real-time trading performance.
Core Components
| component | file | purpose |
|---|---|---|
OnlineParameterStore |
src/online_parameters.py |
Persistent per-pair, per-regime parameter storage with checkpointing |
GradientEstimator |
src/online_parameters.py |
Finite difference gradient computation ∂PnL/∂θ |
ParameterOptimizer |
src/online_parameters.py |
Adam-style optimizer with gradient clipping, learning rate decay, safety reverts |
SpreadRegimeDetector |
src/spread_regime_detector.py |
Regime detection: ranging, trending_up, trending_down, high_volatility |
MetaLearningOptimizer |
src/meta_optimizer.py |
Adaptive learning rates based on performance trends |
TransferLearningInitializer |
src/meta_optimizer.py |
Parameter initialization for new pairs from similar profitable pairs |
Gradient Update Flow
1. Record trade outcome (PnL, parameters used, regime)
2. Compute gradient via finite differences: ∂PnL/∂θ
3. Apply meta-learning learning rate: η_t = f(performance_history)
4. Update parameters: θ_t+1 = θ_t - η_t × ∇L
5. Check safety bounds, revert if performance degrades significantly
6. Store updated parameters in OnlineParameterStore
Loss Function
The JEPA loss combines embedding prediction error with probabilistic prediction:
# JEPA Loss
loss = embedding_loss + prediction_loss

# Embedding loss: L2 distance between predicted and target embeddings
embedding_loss = MSE(predicted_z_t, target_z_t)

# Prediction loss: Negative log-likelihood of actual prices
prediction_loss = NLL(mean_pred, var_pred, actual_prices)

# Combined (with optional weighting)
loss = embedding_loss + prediction_loss
JEPA Modes
| mode | configuration | use case |
|---|---|---|
| Standard JEPA | use_jepa: true, use_stop_gradient: true |
Target encoder frozen (default) |
| I-JEPA | ema_decay: 0.996 |
Momentum encoder (experimental) |
| Direct | use_jepa: false |
No embedding prediction loss |
Training
Quick Start
# Train with best configuration
python scripts/train_best_config.py \
    --symbol AMZN \
    --config configs/conv1d_mlp.yaml \
    --device cuda

# Train on remote GPU (ada)
./scripts/train_remote.sh \
    --config configs/transformer_attn.yaml \
    --symbol AAPL
Monitoring
Training progress is logged to Weights & Biases:
# View real-time results
open https://wandb.ai/msk/tickle
Key Metrics
| category | metric | description |
|---|---|---|
| Prediction | mse_ohlcv |
Mean squared error on all features |
| Prediction | mse_close |
MSE on close price |
| Directional | dir_accuracy |
% correct direction |
| Directional | dir_accuracy_1pct |
% correct for moves > 1% |
| Calibration | nll |
Negative log-likelihood |
| Calibration | calibration_error |
Expected calibration error |
| Financial | sharpe_simulated |
Sharpe of naive strategy |
| Financial | win_rate |
% profitable predictions |